免费 · 无需注册

免费 GEO 单页检测

单页 GEO 快检帮你 30 秒看清一个页面能不能被 AI 引用:65 项检查分六类打分,另附 robots、llms.txt、结构化数据三项门禁。适合站长、内容团队与 SEO 顾问——新文章发布、落地页改版后各测一次。

作者:立言GEO 内容团队 最后更新: 内容标准与纠错

免费额度:每分钟 4 次 / 每小时 15 次。

根据 Princeton、Georgia Tech 等机构 2024 年的 GEO 研究,AI 引擎回答问题时会「摘引」具备特定形态的网页段落——自包含的答案块、可抓取的门禁、机器可读的结构说明(Princeton、Georgia Tech 等 2024 年 GEO 研究)。单页 GEO 快检把这件事拆成 65 项可验证的检查,逐项给出通过、警告与改进建议,所有检查与立言GEO 全站审计使用同一套规则。典型用例:新文章发布后验证可引用性、落地页改版后复检、排查某组问题引用集体消失的原因。

与传统的 SEO 体检不同,这里只测「AI 能不能读懂并引用你」:页面框架清不清楚、标题层级有没有跳级、内容里有没有具体数字与专名、答案块能不能脱离上下文独立成立、AI 爬虫有没有被 robots 拦住(各引擎抓取口径见 Google Search Central 抓取文档)、有没有 llms.txt 导读、Schema 是否声明了页面类型。评分口径与主流单页审计工具一致:分类得分 =(通过 + 0.5×警告)/ 检查数,总分取六类算术平均,70 分及格。

报告怎么读:先看总分,再看是哪一类拖后腿

一份报告里有一个总分、六条分类条、65 行明细。按下面四步看,三分钟就能定位问题在哪。

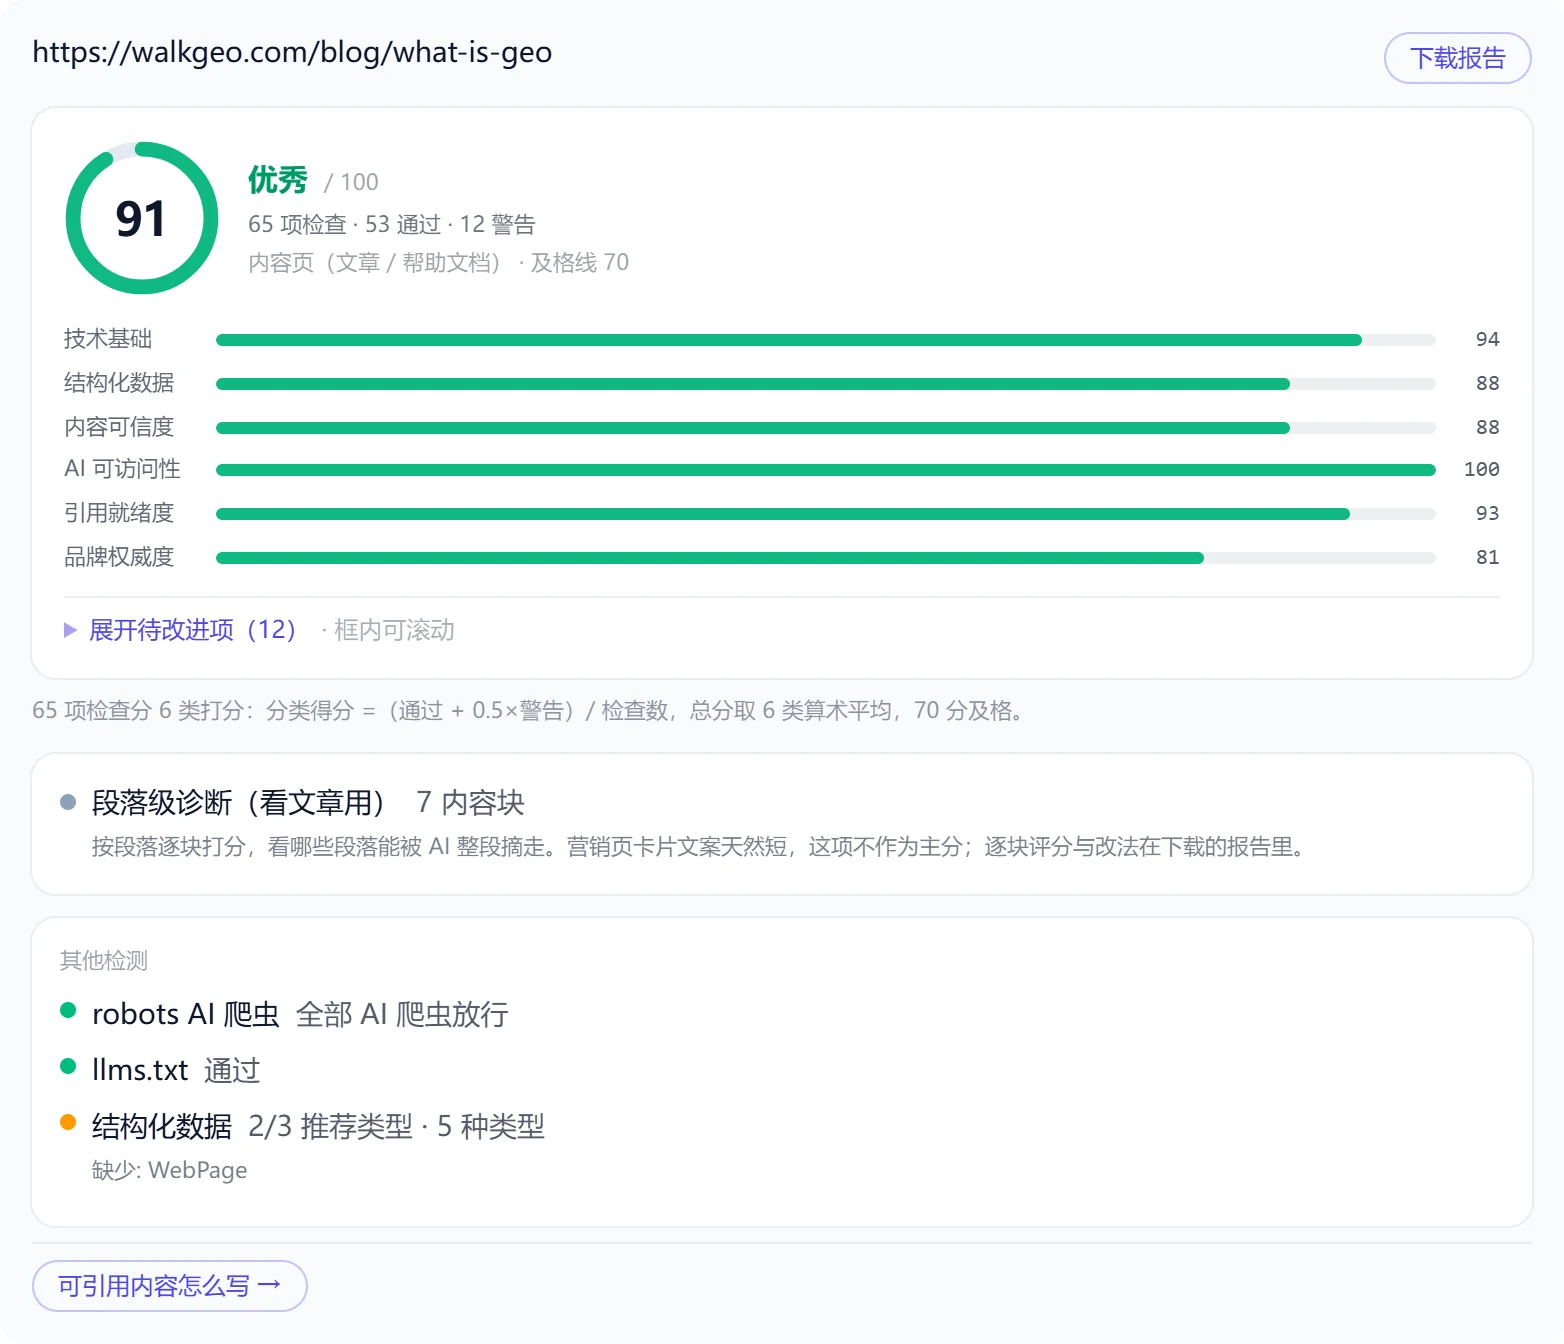
单页 GEO 检测结果示例:walkgeo.com/blog/what-is-geo 得 91 分,65 项检查中 53 项通过、12 项待改进;六类得分为技术基础 94、结构化数据 88、内容可信度 88、AI 可访问性 100、引用就绪度 93、品牌权威度 81。
示例:用本工具实测我们自己的一篇文章(91 分 · 65 项检查 · 12 个待改进项)。下载的报告里可以看到每一项的判定依据。
01

总分只做粗筛,70 分及格

总分是六类得分的算术平均,用来判断这一页能不能进 AI 答案的候选池:60 分以下基本不会,70 分以上说明结构过关、剩下是内容打磨。但总分不告诉你该改什么,那是下一步的事。

02

六条分类条告诉你卡在哪

先看分数最低的那一类。两种典型情况:技术基础 100 但引用就绪度 60,说明页面抓得到、内容却不像答案块;引用就绪度 90 但技术基础 60,说明内容写得好、AI 爬虫却进不来,这种最可惜,因为改一个 robots 规则就能救回来。

03

红色的先修,黄色的后修

「必须修」是硬伤,会直接挡住 AI 抓取或渲染,优先处理;「建议改」是加分项,可以按分类顺序批量改。一次别动超过 10 项,否则复测时分不清是哪一项起了作用。

04

改完用同一个 URL 复测

分数是确定性规则算出来的,同一个页面两次检测结果完全一致,所以可以直接对比改前改后。建议改一批、测一次、把分数记下来,比凭感觉判断靠谱。

六个分类分别在测什么,怎么修

每类下面是这一类最常扣的分,以及对应的改法。打开你自己的报告,对着类别逐条找就行。

技术基础

AI 能不能顺利把页面抓下来、渲染出来。8 项:DOM 规模、渲染阻塞资源、首屏懒加载、内联 JS 体积、图片宽高、viewport、canonical、移动端横向滚动。

常见扣分

  • 图片没写 width 和 height,加载前撑不住盒子,布局抖动
  • head 里挂了多个同步脚本,首屏被推迟
  • 首屏主图标了 loading="lazy",LCP 直接变慢

怎么修

  • 所有 img 补 width 和 height,CSS 照样能控制显示尺寸
  • 脚本加 defer 或 async;首屏主图加 fetchpriority="high"
  • DOM 节点压到 2000 以内,超了多半是组件嵌套过深

结构化数据

机器读不读得懂你是谁、这是什么页面。8 项:有没有 JSON-LD、能不能解析、必填字段、Organization 完整度、sameAs、实体命名一致、页面类型匹配、面包屑。

常见扣分

  • 只声明了 Organization,缺 WebSite 和 WebPage
  • Organization 没有 sameAs,AI 无法把品牌和外部资料对齐
  • schema 里写 WalkGEO、title 里写中文名,两边对不上

怎么修

  • 补齐 Organization + WebSite + WebPage 三件套
  • sameAs 填真实存在的社交主页、百科条目、GitHub 仓库(来源:schema.org 的 sameAs 定义)
  • 中英双语品牌用 alternateName 声明别名,别让两个名字打架

内容可信度

内容像不像一个可信来源写的。16 项:价值主张、目标用户、首屏是否拖沓、可读性、方法论、作者信息与署名、权威引用、编辑政策、数字密度、客户与评价、更新日期、联系方式、隐私条款、论断出处。

常见扣分

  • 整页找不到一个具体数字,全是形容词
  • 没有作者署名,AI 无法判断是谁在说这话
  • 引用了别人的结论,却没给出处

怎么修

  • 每个论断配一个来源:机构名 + 年份 + 数字
  • 文章页加作者卡:姓名、职位、相关经历
  • 页脚放隐私政策、服务条款、可点的联系方式

AI 可访问性

AI 读到的和你看到的,是不是同一份东西。10 项:H1 是否存在且唯一、是否允许索引、正文是否在 HTML 里、语义地标、html lang、标题层级、图片 alt、正文与标记的比例、页脚是不是脚本注入的。

常见扣分

  • 正文靠 JS 渲染,抓下来的 HTML 里是空的
  • 一页有两个 H1,或者根本没有 H1
  • 标题从 h2 直接跳到 h4

怎么修

  • 关键正文服务端渲染或预渲染,别等 JS 跑完
  • 一页一个 H1,其余用 h2 和 h3 组织
  • 标题层级逐级递进,别跳级

引用就绪度

这一段能不能被整段摘走。14 项:自包含、答案块长度、含数字、含专名、定义句、问句式标题、答案是否紧跟标题、编号结构、列表表格、原创信号、首屏套话、可摘引块数量、标题长度、FAQ 结构。

常见扣分

  • 段落以「它」「这个」「因此」开头,摘出来看不懂在说什么
  • 标题写「我们的优势」,而不是用户会问的那句话
  • 铺垫三段才给答案,AI 早就跳过了

怎么修

  • 段落第一句写完整主语:把「它能提升 37%」改成「立言GEO 的监测能提升 37%」
  • 标题改成用户会问的问法,比如「GEO 和 SEO 有什么区别」
  • 答案放在标题正下方第一段,铺垫和背景放后面

品牌权威度

AI 能不能确认你是一个真实存在的实体。8 项:命名一致、logo、社交足迹、关于页、联系入口、Wikipedia/Wikidata、GitHub 生态、权威外部来源。

常见扣分

  • 没有关于页,不知道你是谁、团队在哪
  • 没有任何第三方页面提到你
  • 品牌名在不同位置写法不一致

怎么修

  • 建一个关于页:公司做什么、团队是谁、注册地、联系方式
  • 补 sameAs,把能证明身份的外部链接都挂上
  • 争取第三方提及:行业媒体、开源仓库、评测站

按这个顺序修,别东改一项西改一项

前一步是后一步的前提——顺序错了,后面的优化根本不会被看到。

  1. 1

    先开门:放行爬虫、正文进 HTML

    robots 放行 GPTBot、PerplexityBot、Bytespider 这类索引型爬虫,页面允许索引,正文出现在 HTML 里。这一步没做,后面所有优化都是零。

  2. 2

    再声明身份:补 schema 与 sameAs

    补 Organization + WebSite + WebPage,填 sameAs,让 schema 里的名字和 title 一致。AI 得先知道你是谁,才谈得上引用你。

  3. 3

    再修结构:H1、层级、语义地标

    一页一个 H1,标题层级不跳级,补语义地标(header、main、article、footer),图片补 alt。这些是 AI 切分段落时的路标。

  4. 4

    最后修内容:答案块与出处

    答案块改成自包含、标题改成问句、每个论断配数字和出处、补 FAQ 结构。这一层见效最慢,但决定最终能不能被摘引。

这个分数是什么,不是什么

分数由 65 条确定性规则算出,不调用任何 AI 模型。同一个页面今天测、明天测、换个人测,结果完全一致——这样才能拿它做前后对比。

它测的是「和可被引用高度相关的页面特征」,是代理指标,不是 AI 引擎的实际行为。高分不保证你被引用,但低分基本意味着不会被引用。65 项检查的阈值不是拍脑袋定的——数据来自我们对 61 个真实页面的分位标定(2026 年 11 月),每个阈值都落在能区分好坏的位置上。

想验证 AI 到底有没有引用你,得真的去问:在豆包、DeepSeek、通义千问、元宝里搜你的品牌和核心问题,看答案里有没有出现你。那是另一件事,也是立言GEO 产品每天在做的事。

三种典型用法

  1. 新文章发布后:先测一次,确认答案块、schema、robots 都到位,再去提交收录。带着结构问题提交,AI 抓到的是半成品。
  2. 落地页改版后:对比改版前后的分数,确认没把可引用性改坏——改版最容易踩的坑是把正文搬进了客户端渲染。
  3. AI 引用突然消失:先测一遍门禁。八成是 robots 被加了拦截规则,或者页面改成 JS 渲染、抓下来的 HTML 变成空壳。

常见问题

检测的是整站还是单个页面?

单个页面。GEO 快检按 URL 逐页分析,适合先验证最重要的几篇文章或落地页;要看整站,用立言GEO 的全站审计,一次跑完全部页面并给出优先级。

报告里的分数是怎么算的?

总分是 6 个分类得分的算术平均,分类得分 =(通过数 + 0.5×警告数)/ 该分类检查数,70 分及格——与主流单页审计工具同一口径,方便横向对比。另附一份段落级诊断:按内容块逐块打分,列出哪些段落能被 AI 整段摘走、哪些需要重写,逐块明细在下载的报告里。

分数高就一定会被 AI 引用吗?

不一定。分数衡量的是页面具备不具备被引用的条件,而 AI 最终引不引用还取决于你的品牌知名度、问题匹配度、以及竞争对手在同一问题下的表现。分数低基本不会被引用,分数高只是拿到了入场券。

为什么同一页面在别的工具上分数不一样?

因为检查项和权重不同。有的工具把 CSP、TLS 版本、Permissions-Policy 这类安全头也算进去,占了六成以上权重;有的只测内容。同一份报告在不同工具间只比趋势、不比绝对值,看分数涨没涨比看分数本身更有意义。

改完之后多久生效?

技术上立刻生效——改完重新检测,分数马上变。但 AI 引擎的索引有延迟,通常几天到几周不等,取决于各引擎的抓取频率。robots 和 llms.txt 这类门禁类修改生效较快,内容类修改需要等下一次抓取。

robots 显示有爬虫被拦,要紧吗?

看被拦的是谁。GPTBot、PerplexityBot 这类索引型爬虫被拦,意味着对应 AI 引擎无法引用你的页面;纯训练型爬虫被拦不影响被引用。工具会逐个列出爬虫名称与放行状态。

检测结果会保存或公开吗?

不会。检测实时执行、结果只返回给你的浏览器,不入库、不公开。免费额度为每分钟 4 次、每小时 15 次。

相关阅读

还需要生成 llms.txt?用免费生成器 →

注册工作台 · 首次免费

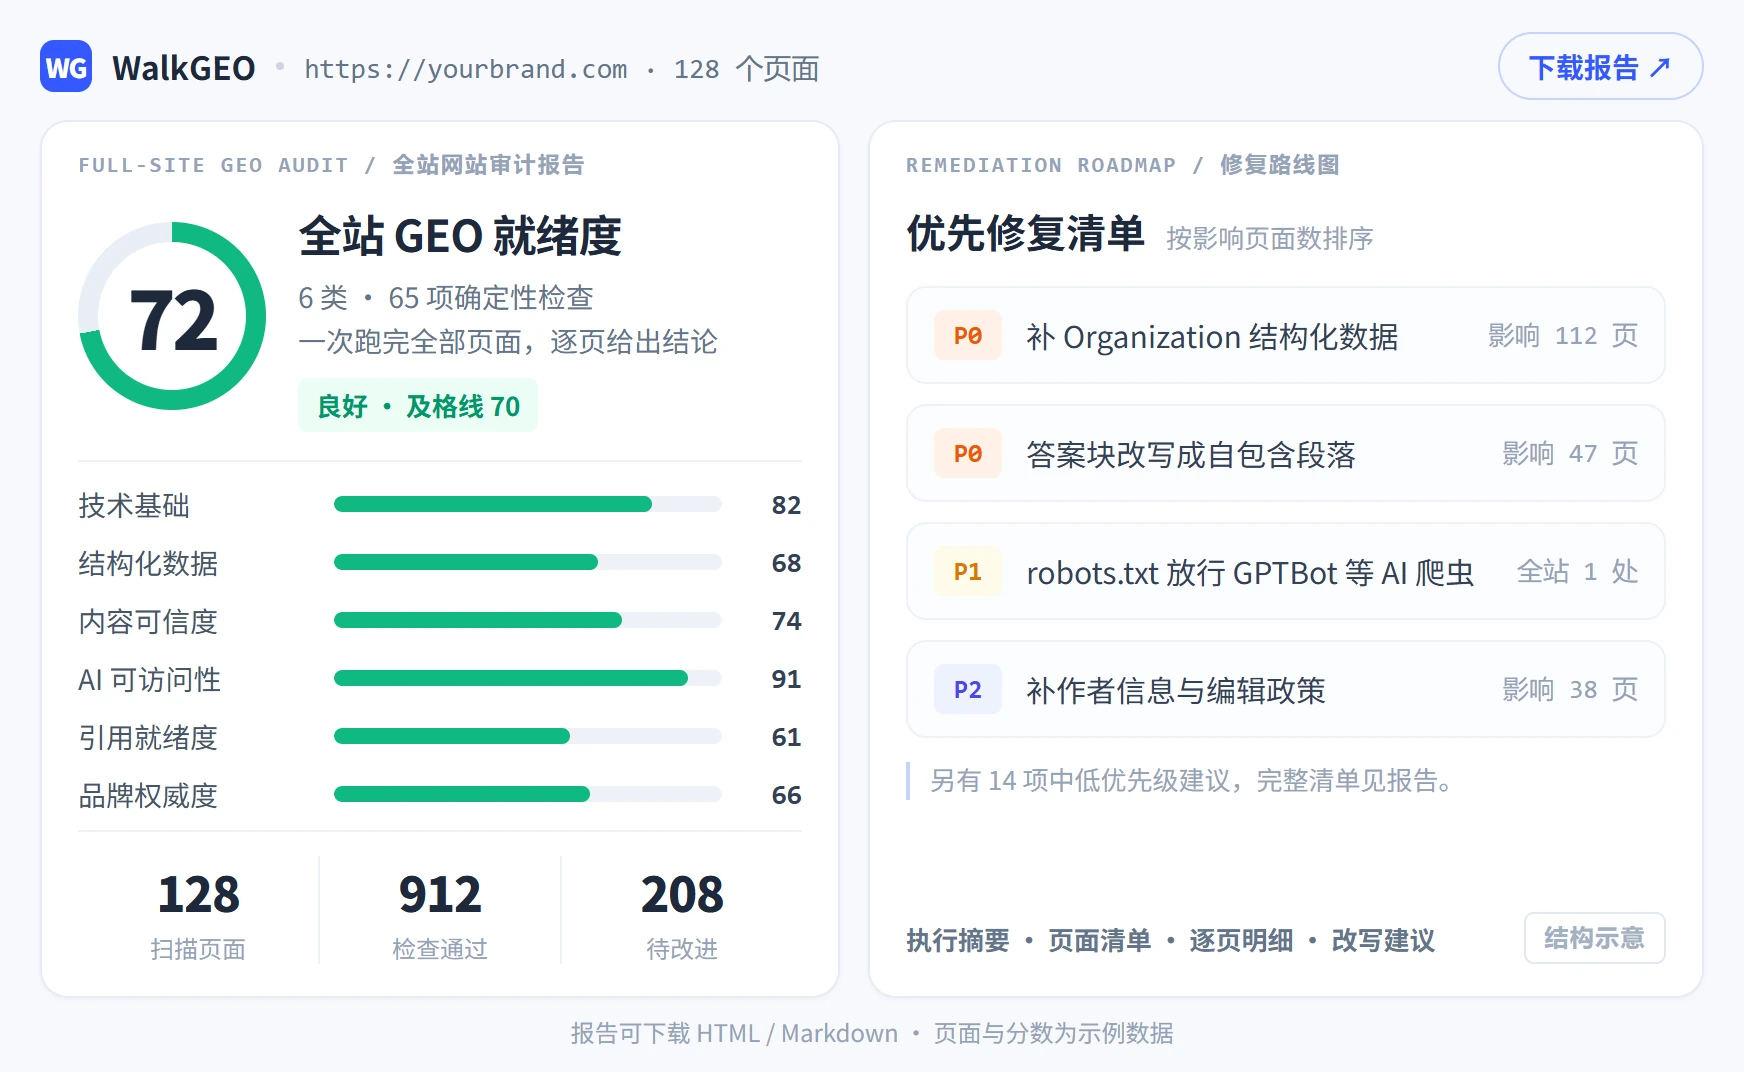
一份全站审计报告,告诉你先改哪里。

注册进入工作台,一次跑完全部页面,拿到按优先级排好的修复清单。

免费做一次网站审计
首次免费全站一次跑完报告可下载
全站网站审计报告结构示意:全站 GEO 就绪度评分、六类分项与按优先级排列的修复清单
网站审计报告 · 结构示意 · 可下载